

AIOPS
AIOps : l’IA au cœur des opérations DevOps
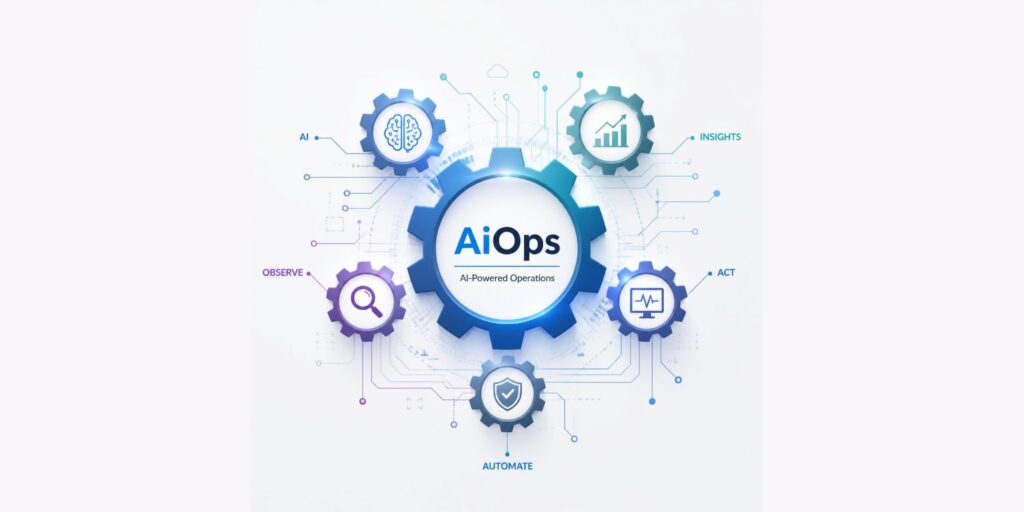
Quand d’un côté, le DevOps industrialise la livraison logicielle (pipelines CI/CD, Infrastructure as Code, automatisation des déploiements), de l’autre, l’AIOps automatise l’intelligence. Là où le DevOps a remplacé les processus manuels par des pipelines, l’AIOps remplace les décisions manuelles par des analyses et des actions pilotées par l’IA.
Ce n’est pas un sujet prospectif. Nous le constatons d’ailleurs directement sur nos missions DevOps. L’adoption de la supervision pilotée par IA est passée de 42 % à 54 % des entreprises entre 2024 et 2025 (Mordor Intelligence). Les équipes qui ont déployé des solutions AIOps constatent une réduction du MTTR (temps moyen de résolution des incidents) de 40 % ou plus (Rootly). Le marché lui-même atteint 14,4 milliards de dollars en 2026, avec un taux de croissance annuel de 30 % (Research and Markets).
Cet article décrit ce qui se passe déjà sur le terrain, et ce que ça change concrètement pour les équipes Dev et Ops.
- I) AIOps : définition et périmètre réel
- II) AIOps vs DevOps vs MLOps : comment les distinguer ?
- III) AIOps : les 4 cas d'usage les plus matures
- IV) AIOps : ce que ça change pour les équipes Dev et Ops
- V) AIOps et IaC : une combinaison qui change la donne
- VI) Les conditions pour que l'AIOps fonctionne vraiment
- En résumé
1. L’assistance à la rédaction de code dans l’IDE
C’est le cas d’usage le plus visible et le plus adopté. GitHub Copilot, Cursor ou JetBrains AI proposent complétion, génération de tests, explication et refactoring, directement dans l’IDE.
Sur l’une de nos missions dans le secteur ferroviaire, des équipes dédiées à l’IA ont fourni aux développeurs des outils intégrés dans leur IDE, capables de produire du code à partir de prompts et d’accélérer significativement la production de fonctionnalités. L’impact sur la productivité est réel si les équipes s’alignent sur les usages autorisés et la validation du code généré.
2. L’analyse automatique des logs lors d’incidents
C’est probablement le cas d’usage à plus fort impact opérationnel. Lors d’un incident, le système ingère logs, métriques et traces, corrèle les signaux et remonte une analyse de cause racine en quelques minutes.
L’intelligence artificielle ne se contente plus de transmettre chaque alerte au format brut. Elle déduplique les notifications redondantes, regroupe les signaux liés en un seul incident contextuel, et remonte un diagnostic actionnable à l’ingénieur d’astreinte. Ce changement de paradigme transforme radicalement la gestion des incidents : entre 80 et 90 % du volume d’alertes peut être éliminé grâce à la corrélation intelligente des événements (OpenObserve).
3. La détection proactive d’anomalies dans les pipelines
Les architectures modernes (microservices, serverless, multi-cloud) génèrent un volume de données de télémétrie dix fois supérieur à ce que produisaient les architectures monolithiques. Les règles d’alerte statiques ne tiennent plus : elles produisent trop de faux positifs, ce qui génère de la fatigue d’alerte chez les équipes Ops.
L’AIOps remplace ces règles fixes par des baselines dynamiques apprises par machine learning. Le système apprend le comportement normal de chaque service et détecte les déviations avant qu’elles n’impactent les utilisateurs. C’est la différence entre une supervision réactive et une supervision prédictive.
4. La suggestion et l’application de correctifs
Le cas d’usage le plus avancé, encore en phase d’adoption dans la majorité des organisations. Une fois l’anomalie identifiée, certaines plateformes d’AIOps proposent un correctif pré-approuvé, voire l’appliquent automatiquement si la gouvernance le permet.
C’est la logique du pipeline auto-réparateur (self-healing pipeline) : le système observe, diagnostique, décide et agit, sans attendre une intervention humaine à chaque étape. L’enjeu organisationnel est de définir précisément quelles actions peuvent être automatisées et lesquelles nécessitent une validation humaine.

De l’assistance au code dans l’IDE à la suggestion automatique de correctifs, ces quatre cas d’usage illustrent comment l’AIOps s’intègre concrètement dans les pratiques DevOps, avec les impacts mesurés sur le terrain. Source : Rootly (MTTR), OpenObserve (alertes).
L’IA qui analyse les plans Terraform avant déploiement
La convergence entre AIOps et Infrastructure as Code ouvre des cas d’usage particulièrement puissants. Avant d’exécuter un terraform apply, un système IA peut analyser le plan de déploiement, détecter des configurations risquées (ports ouverts, permissions trop larges, ressources non taggées), et alerter l’équipe avant que le problème ne soit déployé en production.
C’est le « shift left » appliqué à l’infrastructure : détecter les problèmes tôt, quand ils sont encore peu coûteux à corriger.
La détection de dérives de configuration en temps réel
Terraform maintient un state file qui décrit l’état souhaité de l’infrastructure. Mais l’état réel peut dériver : une modification manuelle en urgence, une ressource créée hors du cycle IaC, une mise à jour automatique d’un service cloud. L’AIOps surveille en permanence l’écart entre l’état souhaité et l’état réel, et alerte dès qu’une dérive est détectée.
Cette surveillance continue du drift de configuration est l’un des chantiers les plus concrets de convergence entre IaC et AIOps en 2026.
Les dernières
ACTUALITÉS
- Téléchargez notre livre blanc sur la conformité réglementaire dataRGPD, HDS, ISO 27001, NIS2 : notre livre blanc montre comment transformer la conformité data en preuve continue, générée automatiquement dans le delivery logiciel, à partir d’un cas terrain.
- Téléchargez notre livre blanc : briser les silos entre IT et UX pour un parcours client optimalModerniser l’interface ne suffit pas à fluidifier le parcours client : notre livre blanc montre comment aligner front, middle et back avec la méthode Inventiv IT en 5 piliers.
- Téléchargez notre livre blanc sur le Data MeshData Lakes et Data Warehouses n’ont pas fait disparaître les silos de données : notre livre blanc, préfacé par Databricks, présente les 4 principes du Data Mesh et les étapes pour le mettre en œuvre.
- Téléchargez notre livre blanc : de la gouvernance des données à l’intelligence automatiséeLa fiabilité de l’IA et de l’automatisation dépend d’abord de la qualité des données qui les alimentent : notre livre blanc rappelle les rôles clés et le démontre par des cas pratiques chiffrés.
- Téléchargez notre livre blanc sur la Data GouvernanceEnjeux, tendances 2024, comitologie, rôles et bonnes pratiques : notre livre blanc vous aide à instaurer ou perfectionner la gouvernance de vos données.